Исследователи Т-Технологий совместно со Сбером, МФТИ и Университетом Иннополис разработали SimplexLoRA — метод, который повышает качество дообучения языковых моделей. Это достигается за счёт направления большего количества ресурсов на слои, важные для конкретной задачи. Распространённый метод LoRA делит ресурсы между всеми слоями поровну. SimplexLoRA перераспределяет их и при том же объёме вычислений даёт лучший результат. Об этом сообщает Runet.News.
Станислав Моисеев, руководитель Центра исследований и разработок Т-Технологий, отмечает: «При адаптации языковой модели к новой задаче важно понимать, где дополнительные обучаемые параметры принесут наибольшую пользу. SimplexLoRA позволяет подобрать их распределение между слоями в начале дообучения. В наших экспериментах это помогло улучшить результаты при том же количестве обучаемых параметров, особенно когда размер адаптеров был небольшим. Для разработчиков ценность такого подхода — в возможности повысить качество адаптации модели к задаче, сохранив привычную основу LoRA».
Суть открытия заключается в том, что для адаптации языковых моделей к прикладным задачам широко применяется метод LoRA. Он сохраняет основные веса модели неизменными и дообучает её с помощью адаптеров — небольших дополнительных модулей, встроенных в слои модели. При этом всем адаптерам выделяется одинаковое число обучаемых параметров, хотя слои модели вносят неодинаковый вклад в решение конкретной задачи. Исследователи предложили SimplexLoRA — метод, который учитывает эти различия.
На предварительном этапе SimplexLoRA определяет, какие слои наиболее важны для задачи, и перераспределяет между ними общий объём обучаемых параметров: значимым слоям выделяется больше ресурсов, остальным — меньше. Затем распределение фиксируется, и модель дообучается по стандартной схеме LoRA. Благодаря этому качество дообучения повышается без увеличения числа обучаемых параметров и вычислительных затрат.
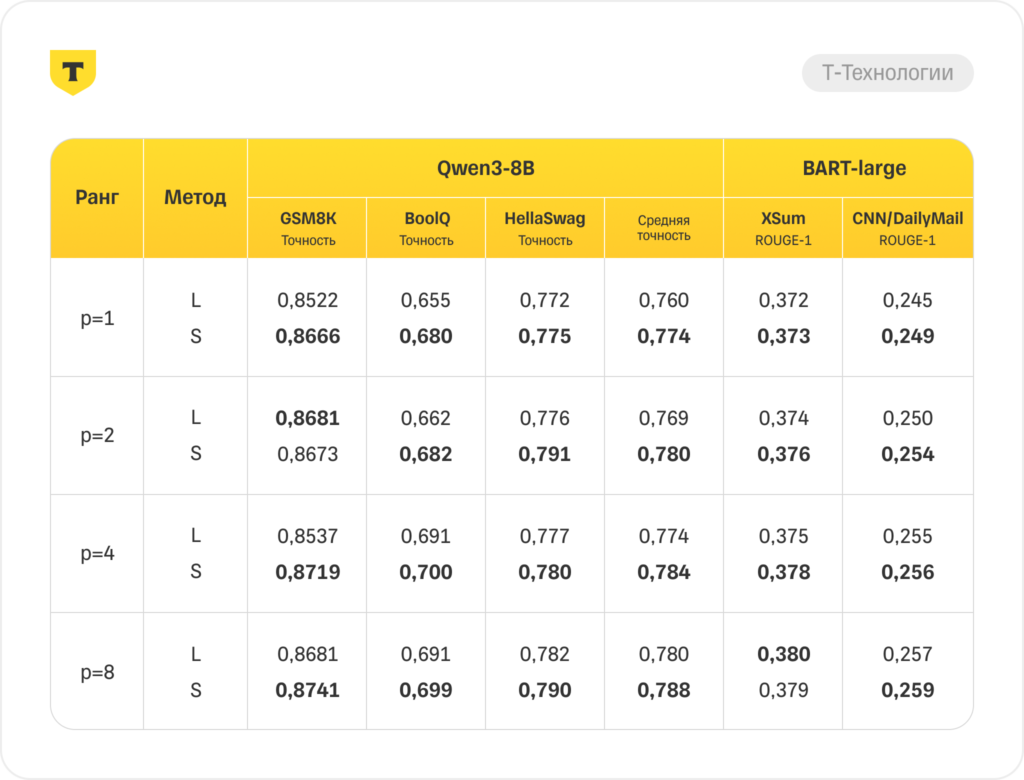
Исследователи протестировали SimplexLoRA на 12 задачах с использованием четырёх моделей: DeBERTaV3, BART-large, Llama 3.1 8B и Qwen3-8B. Эксперименты включали задачи на понимание текстов, подготовку кратких изложений, ответы на вопросы и рассуждение. В большинстве тестов новый метод достигал качества стандартного LoRA или даже превосходил его при том же числе обучаемых параметров и той же стоимости инференса. Метод особенно хорошо работает при небольшом количестве обучаемых параметров, более оптимально распределяя ограниченный ранг между слоями модели и достигая при этом более высокого качества по сравнению со стандартным LoRA.
SimplexLoRA будет полезен командам, которые адаптируют готовые языковые модели к собственным задачам. Среди проверенных в исследовании сценариев — ответы на вопросы, саммаризация документов, анализ эмоциональной окраски текстов, математические рассуждения. Он особенно полезен в ситуациях, когда разработчикам необходимо обучать модели в условиях ограниченных вычислительных мощностей. Исходный код SimplexLoRA опубликован в открытом доступе на GitHub.